Clustering de Bisnagas
Informações do Projeto
- Categoria: Ciência de Dados & Machine Learning
- Tipo: Projeto de Clusterização (EDA → Modelagem )
- Status: Concluído
- GitHub: Ver Repositório →
Python Pandas Numpy Seaborn Matplotlib Scikit-learn K-means Hierarchical Clustering (Ward)
Otimização de Performance Industrial via Clustering de SKUs
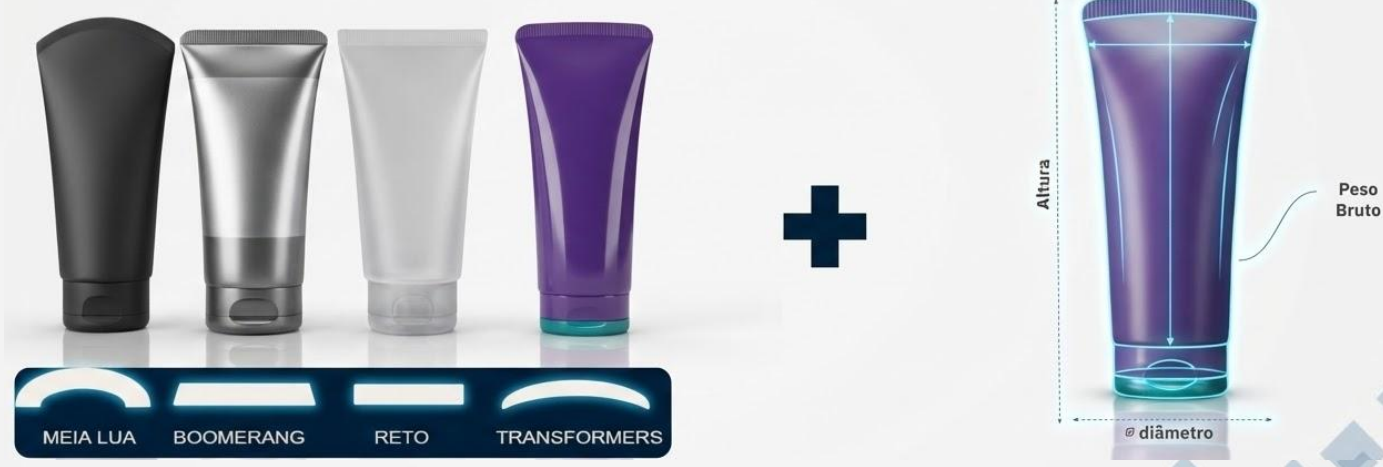
Este projeto aplica técnicas de Aprendizagem de Máquina Não Supervisionada para mapear e agrupar um portfólio complexo de mais de 2.000 SKUs de bisnagas, visando a otimização do sequenciamento produtivo e automação do processo de clustering. O trabalho aborda o desafio crítico de reduzir tempos de setup e aumentar a cadência de produção através da criação de famílias de produtos baseadas em características físicas e técnicas (diâmetro, altura, tipos de selagem). A metodologia envolveu uma análise comparativa robusta entre algoritmos de K-Means, Clusterização Hierárquica (Método de Ward) e Gaussian Mixture Models (GMM), garantindo que os agrupamentos fossem tecnicamente coerentes com a realidade operacional da fábrica.
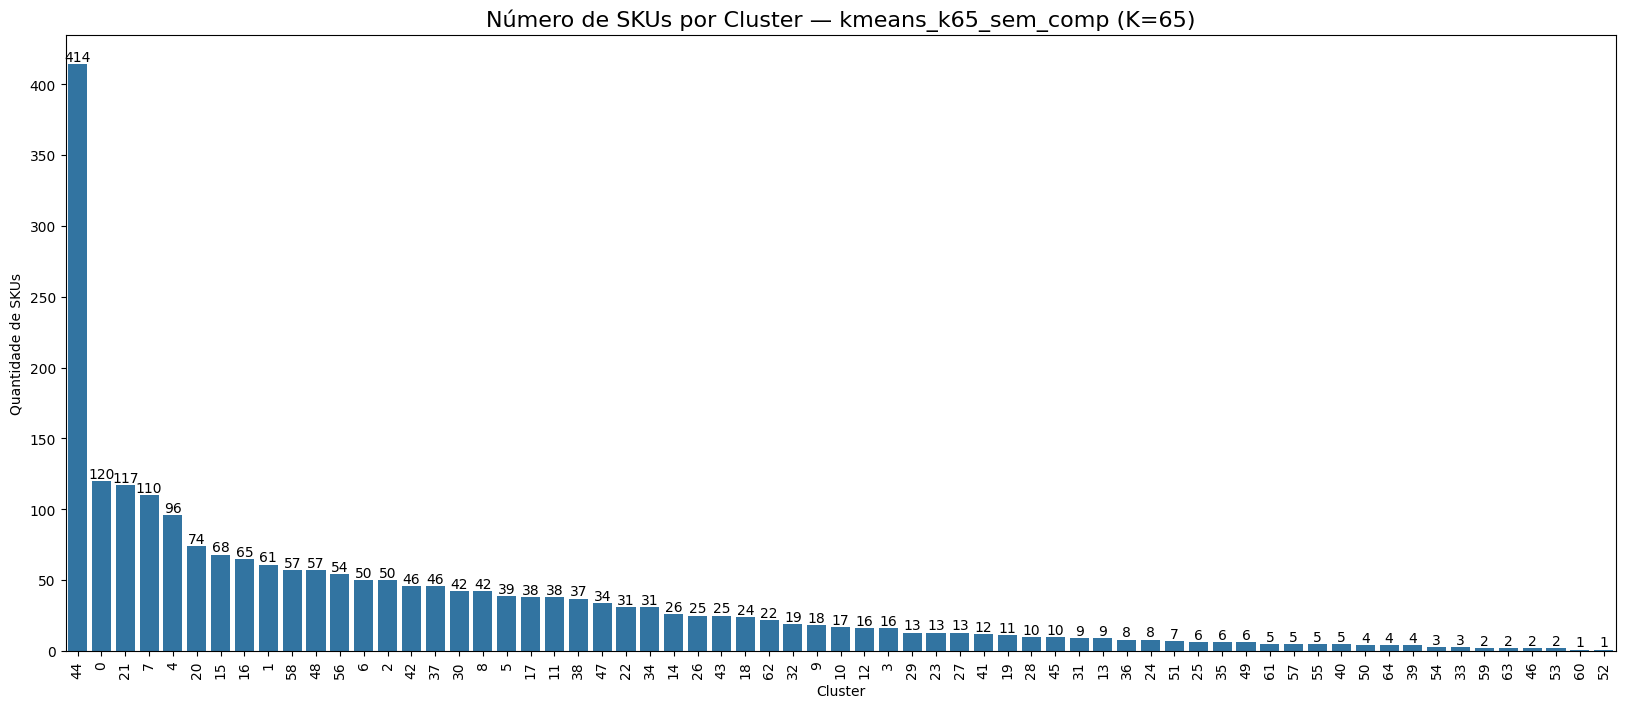
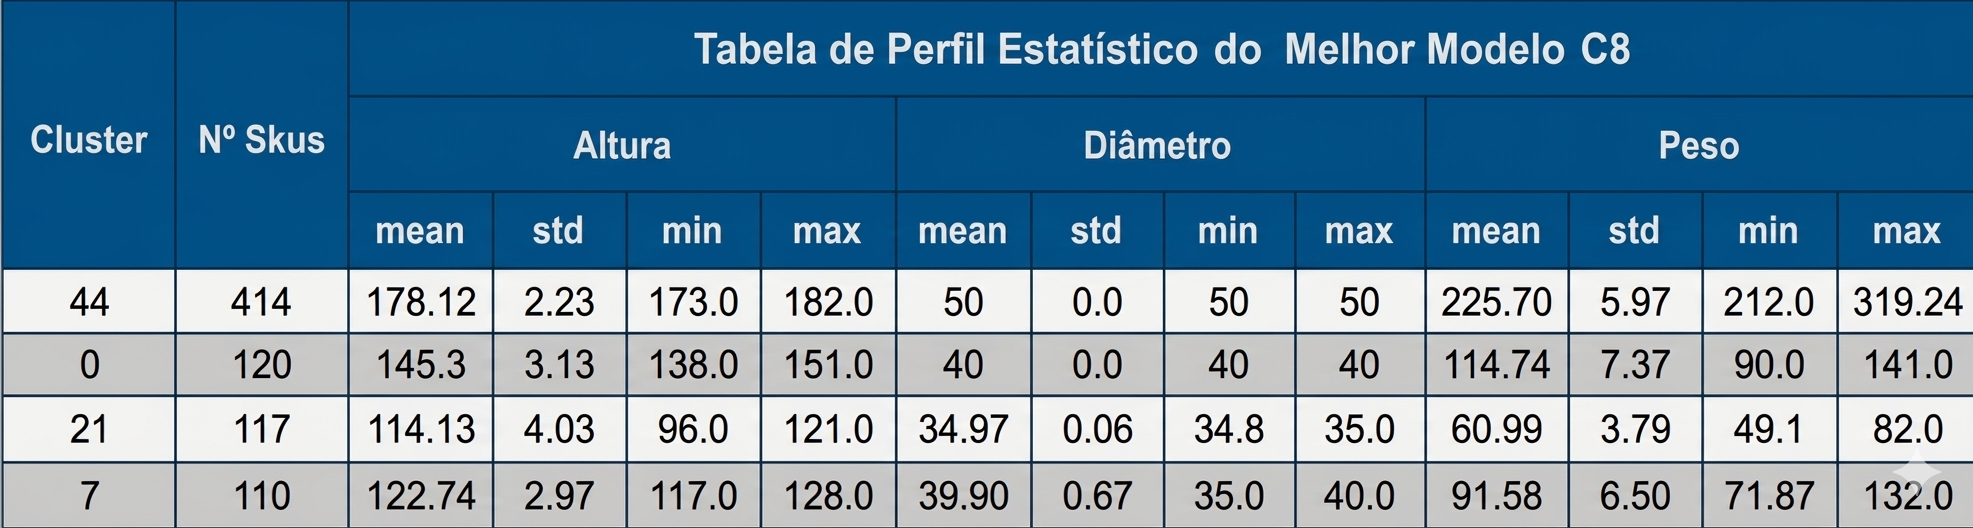
A implementação do modelo final (K-Means com K=65) permitiu a substituição de critérios subjetivos de sequenciamento por um rigor estatístico que resultou em ganhos operacionais imediatos. A otimização dos roteiros produtivos viabilizou a internalização de 7% do volume que anteriormente era terceirizado, gerando um retorno financeiro estimado em R$ 1,5 milhão em receita. Ao agrupar itens com características de envase similares, o projeto maximizou o OEE (Overall Equipment Effectiveness) e estabeleceu uma base sólida para a gestão de categorias no ambiente industrial.
Principais Destaques
- Impacto Financeiro: Viabilização da internalização de 7% do volume terceirizado, gerando R$ 1,5 milhão em receita anual.
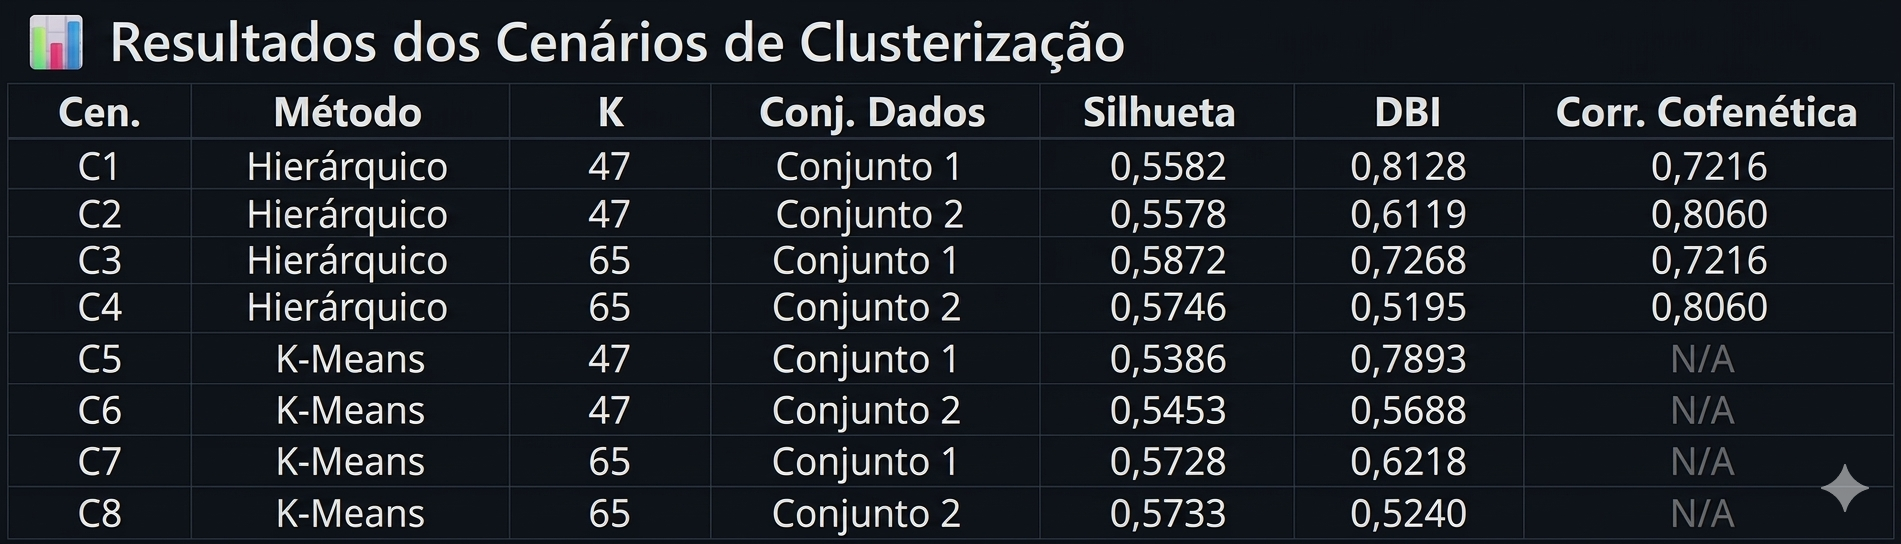
- Validação Multicritério: Uso de Silhouette Score e Davies-Bouldin para garantir a coesão e separação estatística dos 65 clusters.
- Refinamento Hierárquico: Aplicação do Método de Mojena e Correlação Cofenética para definição precisa dos pontos de corte no dendrograma.
- Engenharia de Variáveis: Seleção estratégica de features técnicas e remoção de redundâncias para aumentar a homogeneidade das famílias.
- Otimização de OEE: Redução de tempos de setup e aumento da cadência produtiva através do sequenciamento baseado em famílias.
- Benchmarking de Algoritmos: Análise comparativa entre K-Means, Hierárquico (Ward) e GMM para garantir a robustez do modelo em ambiente industrial.